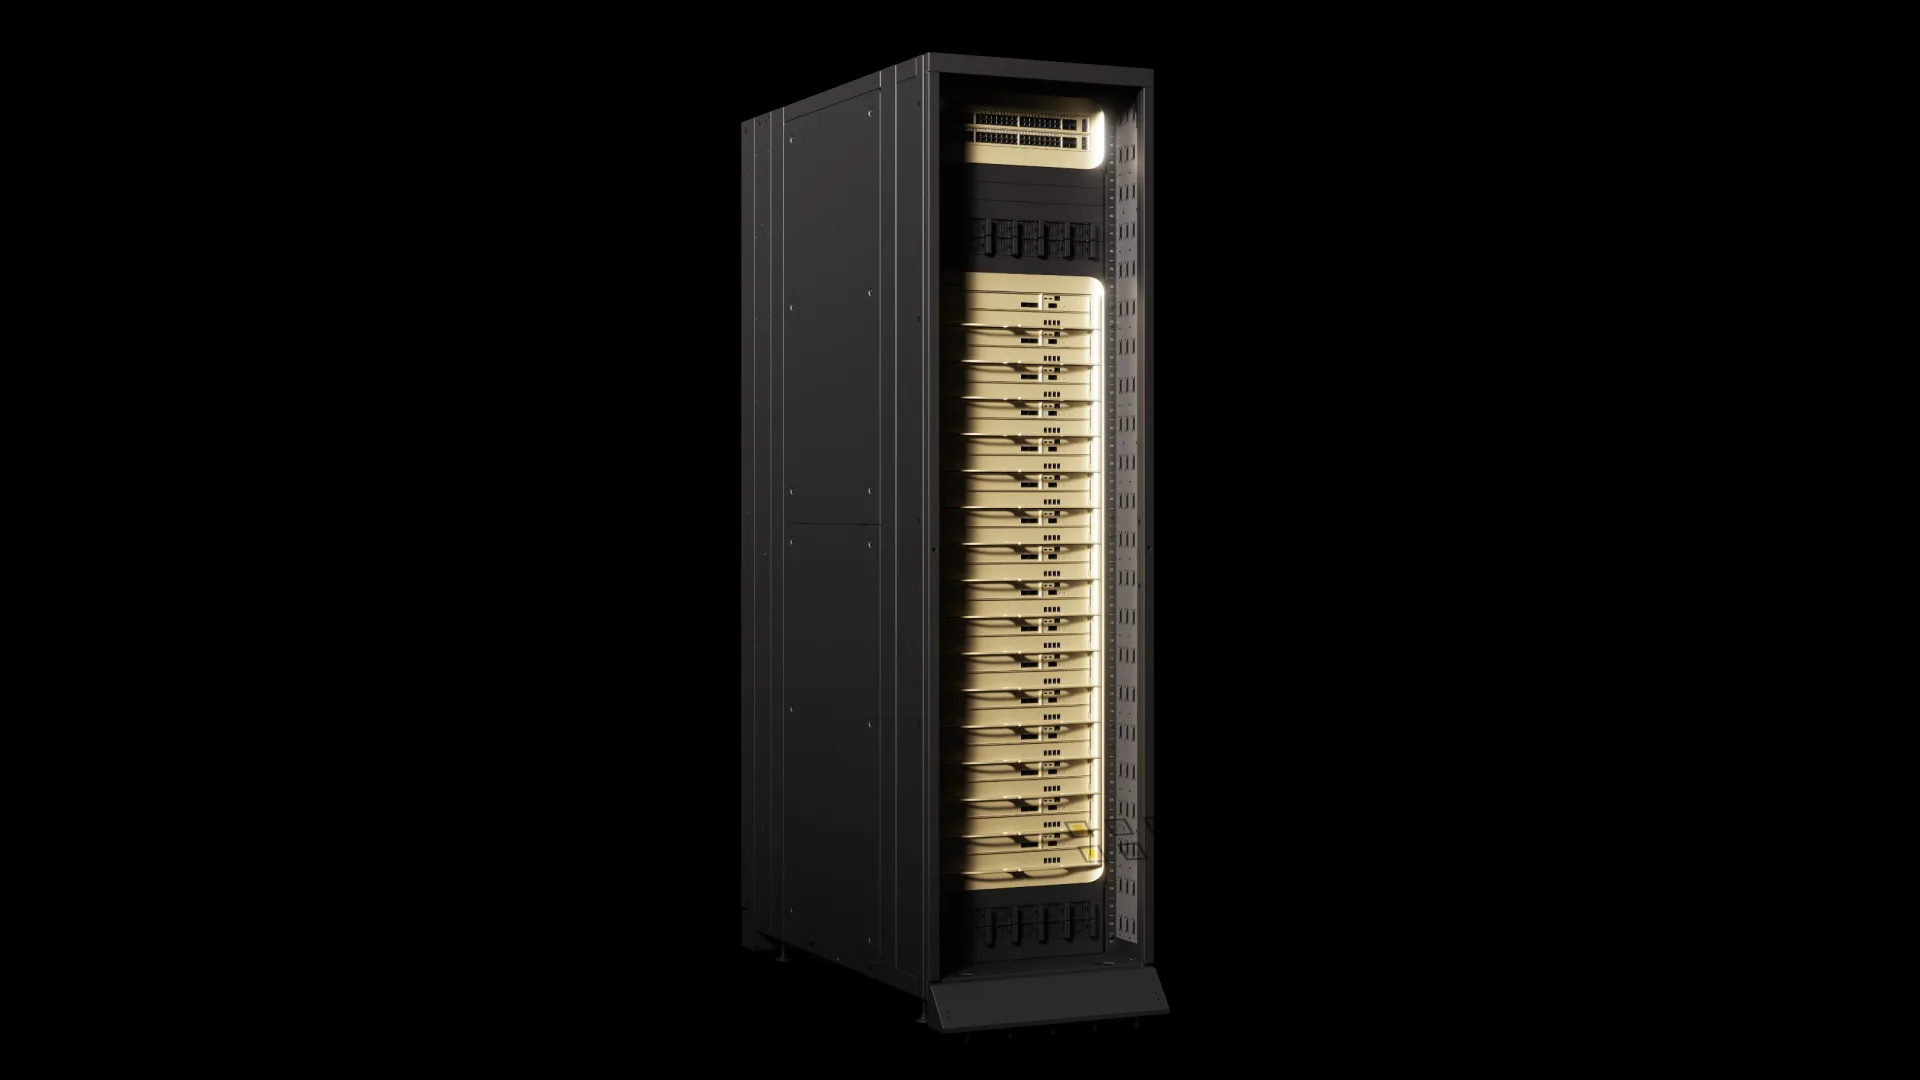
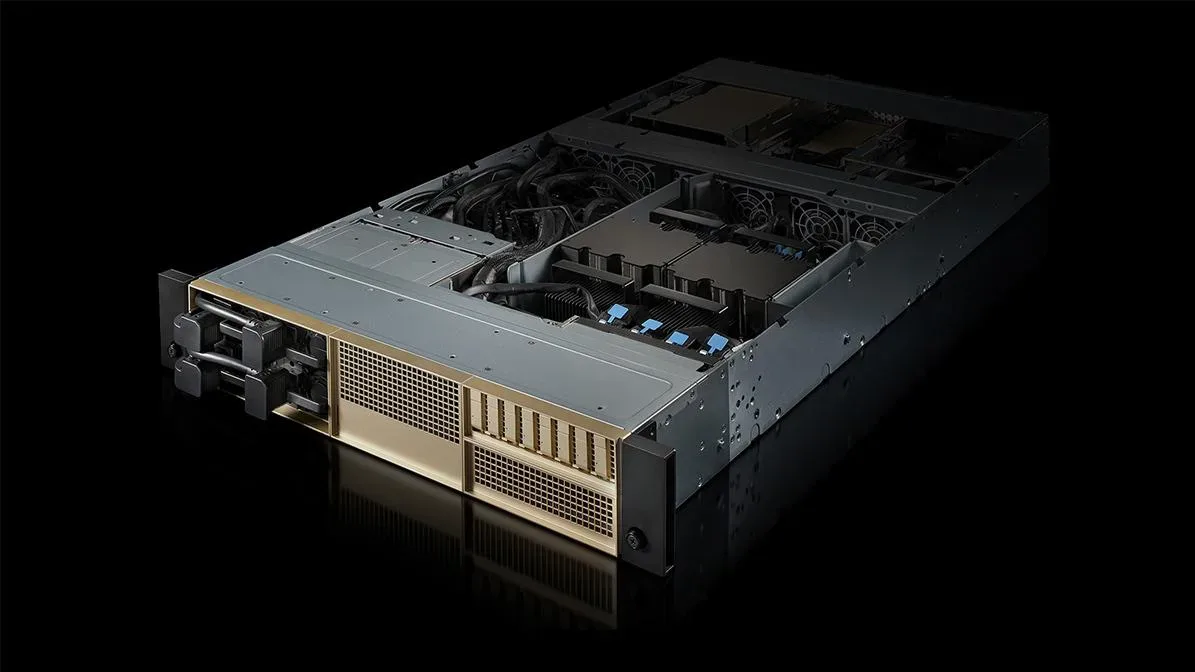
How NVIDIA Groq 3 LPX Deterministic Execution Drives Power-Efficient High-Interactivity Inference on NVIDIA Vera Rubin
Source
Tanya Lenz
Author
Tanya Lenz
Date
Terms in this piece · Glossary
inference — Running a trained model to get answers — the phase where AI is actually used, as opposed to trained.
Why it matters
Pairing Groq's deterministic execution with Vera Rubin NVL72 claims up to 35x more throughput per megawatt than GB200 for 2T+ parameter models, a concrete efficiency lever for anyone planning large-scale inferenceRunning a trained model to get answers — the phase where AI is actually used, as opposed to trained.Full definition → capacity.
 articleAccelerating Dropless MoE Training in JAX with NVIDIA Transformer Engine
 articleWhen to Use Encode-Prefill-Decode Disaggregation to Accelerate Multimodal Model Serving
 articleBuilding a Memory-Driven Agent with NVIDIA NemoClaw
 articleNVIDIA PAIR Virtual Inference Router Expands Available Compute on Your Local Network