Scaling Federated Learning Across Docker, Kubernetes, and Slurm with NVIDIA FLARE
Source
Elizabeth Goodman
Author
Elizabeth Goodman
Date
Why it matters
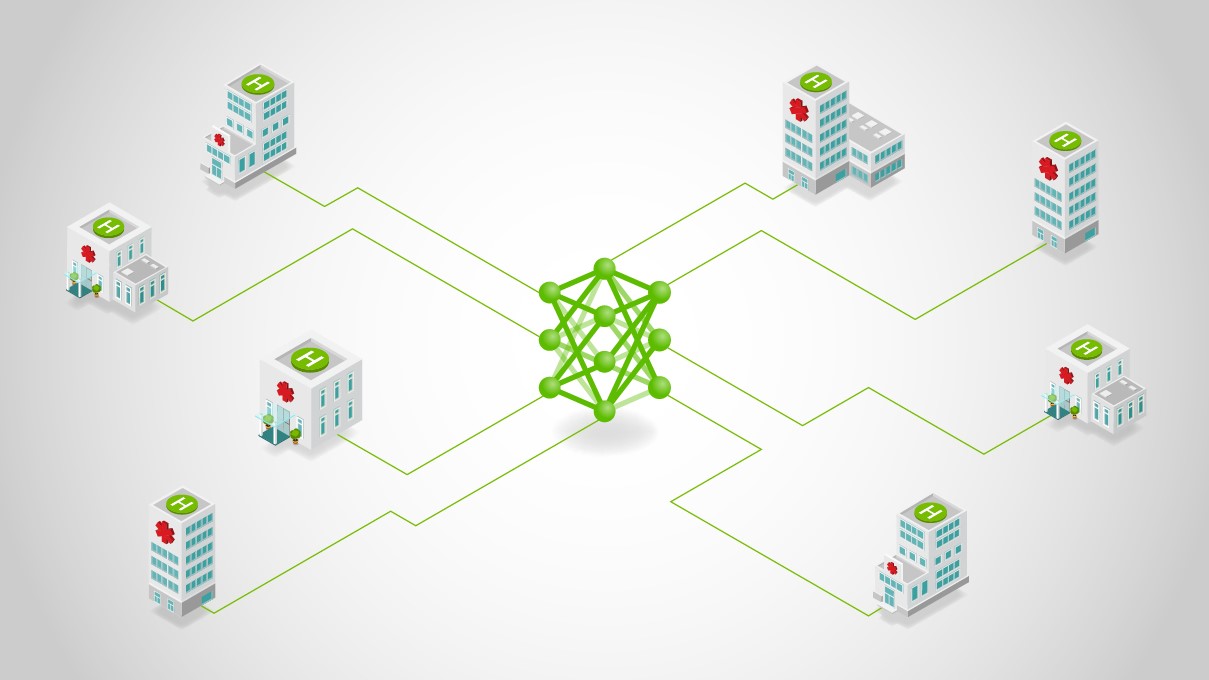
NVIDIA FLARE's split between always-on federation services and per-job workers lets sites run federated learning jobs across Docker, Kubernetes, or Slurm without occupying GPUs when idle, easing deployment across heterogeneous clusters.
 articleDense vs. MoE Models: Active Parameters, Throughput, and When to Choose Each
 articleHow NVIDIA NVLink 6 Delivers Multi-Layer Resiliency for AI Factories
 articleHow Full-Stack NIM Optimizations Deliver 2.5x More Users on Nemotron 3 Ultra
 articleFrom Wafer-Out to First Token: Codifying Supply Chain Expertise with Nemotron and Palantir Foundry